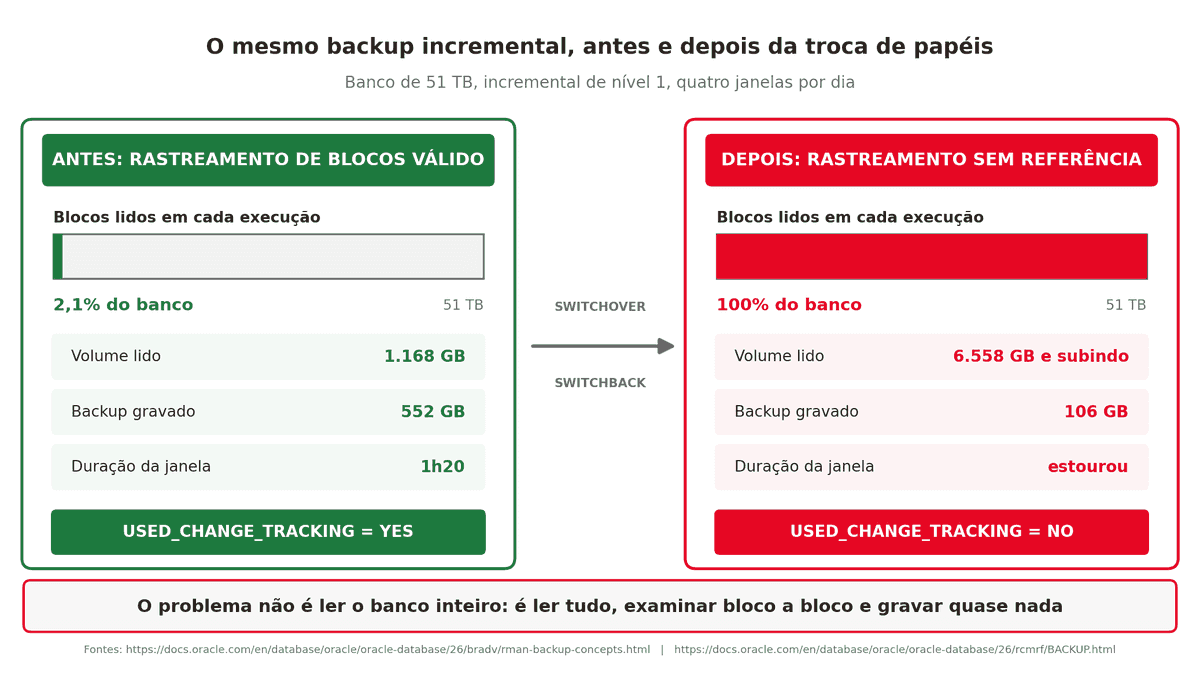
Depois de um switchover seguido de switchback, o backup incremental de um banco de 51 TB parou de ler 2% dos blocos e passou a ler 100%. O Block Change Tracking continuava habilitado, e mesmo assim a coluna USED_CHANGE_TRACKING só mostrava NO.
O que o Block Change Tracking faz
O recurso grava num arquivo binário quais blocos mudaram, conforme o redo é gerado. Com ele, o RMAN vai direto nos blocos alterados em vez de varrer o datafile inteiro.
“The block change tracking file is a small binary file stored in the database area. RMAN tracks changed blocks as redo is generated.”
“If block change tracking is enabled, then RMAN uses the change tracking file to identify changed blocks for incremental backups, thus avoiding the need to scan every block in the data file. RMAN only uses block change tracking when the incremental level is greater than 0, because a level 0 incremental backup includes all blocks.”
Oracle Database Backup and Recovery User’s Guide, seção 8.9.2 About Block Change Tracking
http://docs.oracle.com/en/database/oracle/oracle-database/26/bradv/rman-backup-concepts.html
O arquivo é local do banco, e o nível 0 não usa o rastreamento, porque leva todos os blocos de qualquer jeito.
A condição que decide se o incremental vai ser otimizado está na referência do comando BACKUP.
“The change tracking file maintains bitmaps that mark changes in the data files between backups. The database performs a bitmap switch before each backup. Oracle Database automatically manages space in the change tracking file to retain block change data that covers the 8 most recent backups.”
“The first level 0 incremental backup scans the entire data file. Subsequent incremental backups use the block change tracking file to scan only the blocks that have been marked as changed since the last backup. An incremental backup can be optimized only when it is based on a parent backup that was made after the start of the oldest bitmap in the block change tracking file.”
Oracle Database Backup and Recovery Reference, comando BACKUP, notas de uso sobre Incremental Backups
http://docs.oracle.com/en/database/oracle/oracle-database/26/rcmrf/BACKUP.html
Habilitado é condição necessária, não suficiente. Se o backup pai não for posterior ao início do mapa de bits mais antigo, o RMAN não tem como restringir a leitura, e aí ele lê tudo.
O que a troca de papéis faz com esse arquivo
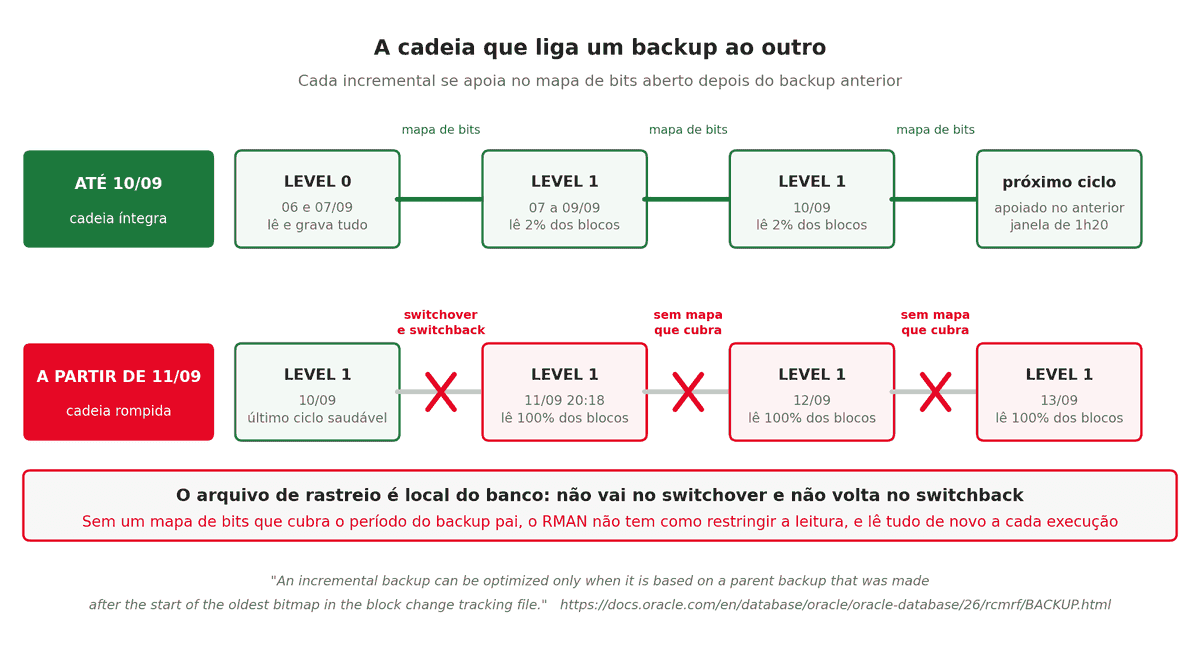
O arquivo de rastreamento pertence ao banco e fica onde está. No switchover, o papel de primário vai para o outro site e o arquivo permanece no site de origem, sem equivalente do outro lado. No switchback, o papel volta, mas a cadeia que ligava os mapas de bits aos backups anteriores não volta com ele.
A partir daí, todo incremental de nível 1 deixa de atender à condição citada acima. O resultado é leitura integral a cada execução, até que alguém restabeleça a referência.
A documentação não traz um parágrafo dizendo “role transition invalida o block change tracking”. Ela dá os dois fundamentos: o caráter local do arquivo e a condição do mapa de bits mais antigo. A prova do efeito vem das visões internas do banco.
A linha do tempo do caso
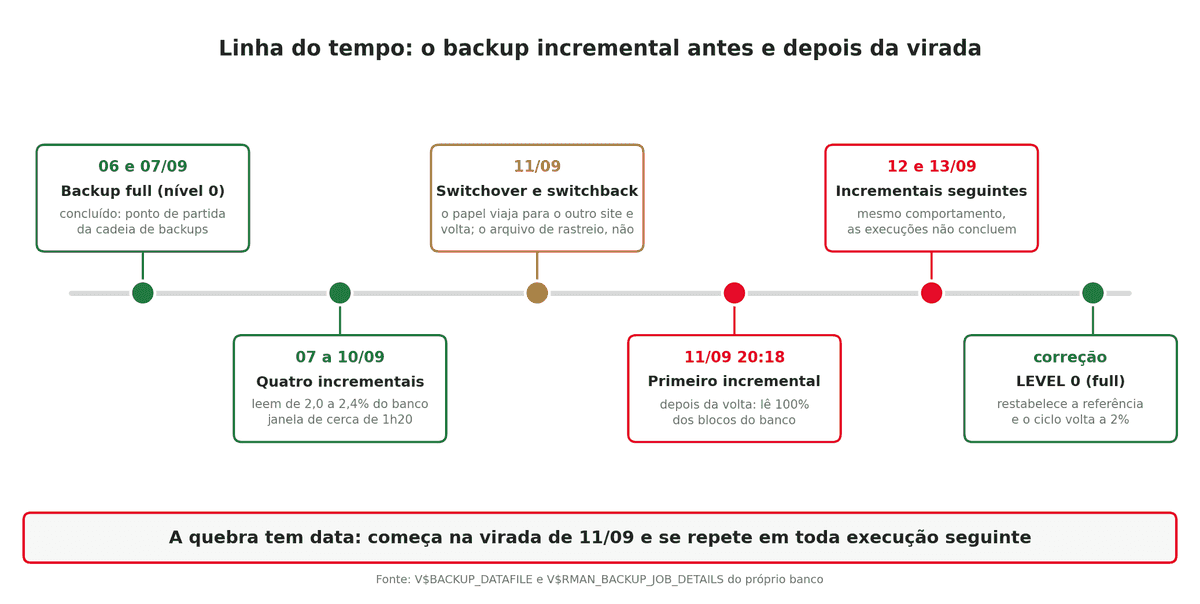
Até 10/09 o incremental terminava lendo de 2,0 a 2,4% do banco, em cerca de 1h20 de janela, com USED_CHANGE_TRACKING em YES. O último nível 0 concluído tinha sido feito em 06 e 07/09, e era ele que sustentava a cadeia.
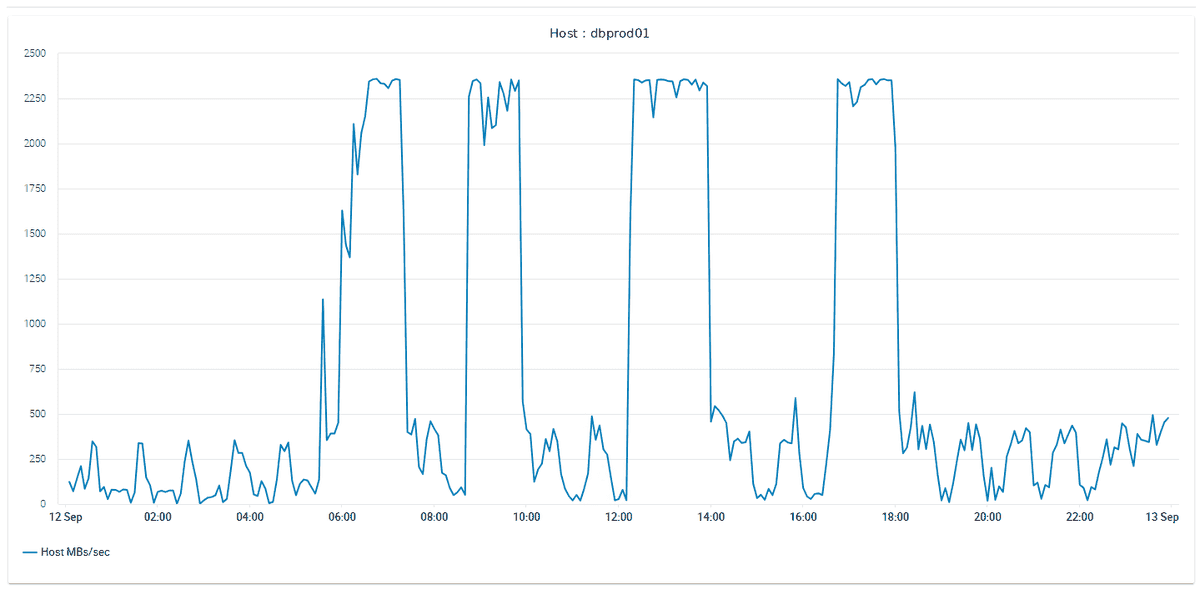
Em 11/09 o ambiente foi para o site de contingência e voltou no mesmo dia. O primeiro incremental depois da volta rodou às 20:18 e leu 100% dos blocos. Em 12 e 13/09 as execuções agendadas repetiram o comportamento e não chegaram ao fim, porque a janela acabava antes de percorrer todos os datafiles.
Entre o ciclo de 2% e o ciclo de 100% não houve mudança nenhuma no banco: mesma versão, mesmos datafiles, mesma rotina de RMAN. Só a troca de papéis.
O problema não é ler tudo
Se o incremental sem rastreamento lê 51 TB e o nível 0 também lê 51 TB, por que um derruba a janela e o outro não?
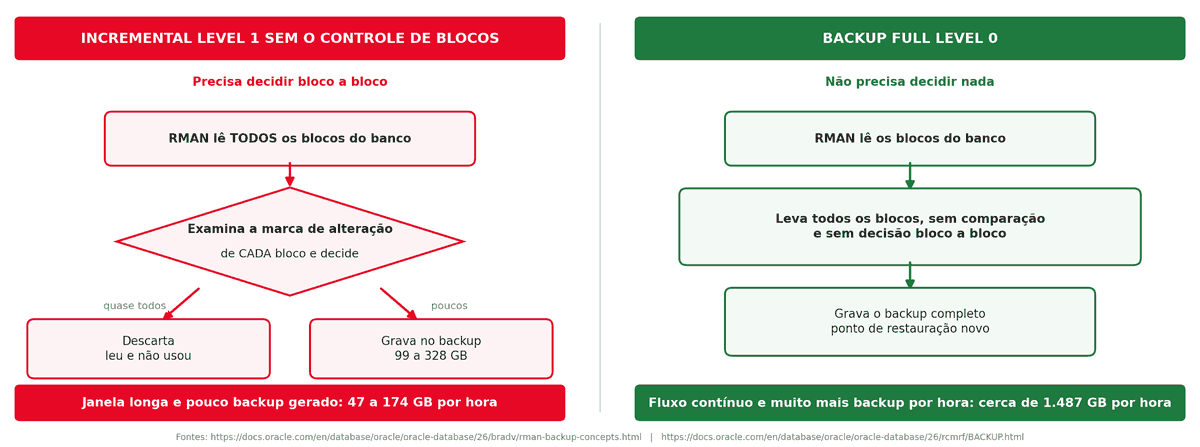
Porque ler é só o começo do trabalho no incremental. Sem os mapas de bits, o RMAN lê cada bloco e ainda precisa examinar o SCN dele, comparar com o incremental start SCN e decidir, um a um, se aquele bloco entra no backup:
“When RMAN makes a level 1 incremental backup of a file, RMAN reads the file, examines the SCN of every block, and backs up blocks whose SCN is greater than or equal to the incremental start SCN for this backup.”
Oracle Database Backup and Recovery User’s Guide, seção 8.9.3 About the Incremental Backup Algorithm
Fonte: http://docs.oracle.com/en/database/oracle/oracle-database/26/bradv/rman-backup-concepts.html
Como a taxa de alteração de um banco grande é baixa, a esmagadora maioria dos blocos é lida, examinada e descartada. A janela inteira é gasta em decisão, e o que sobra de backup gravado é uma fração mínima do que foi lido.
No nível 0 não existe essa decisão. Ele copia todos os blocos com dado, em fluxo contínuo, leitura e escrita caminhando juntas. Por isso o nível 0, mesmo lendo o banco inteiro, entrega muito mais backup por hora de janela.
Onde a fila se forma
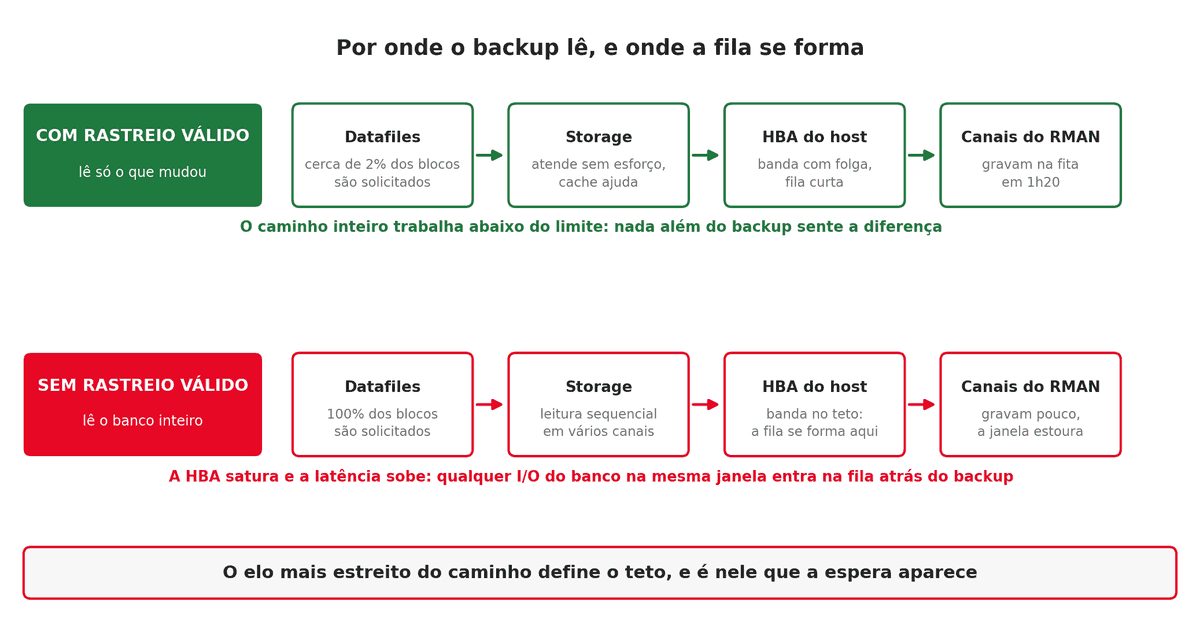
O RMAN lê com vários canais em paralelo, em grandes blocos. É o padrão de acesso que mais consome banda: storage, caminho de fibra e host trabalham no limite do que cada parte aguenta. Com o rastreamento válido, esse esforço é proporcional ao que mudou, cerca de 2% do banco, e o caminho inteiro fica com folga.
Sem o rastreamento, o mesmo caminho passa a carregar o banco inteiro em toda execução. No ambiente do caso, a HBA do host ficou no teto durante toda a janela, e a latência de I/O subiu junto: qualquer operação do banco que precisasse de disco naquele momento entrava na fila atrás do backup. Fora das janelas o consumo voltava ao padrão normal, o que descarta problema de storage ou de configuração do host.
O teto não é defeito de componente nenhum. É o a parte mais estreita do caminho fazendo o que foi dimensionado para fazer, com uma carga que não deveria estar ali.
Diagnóstico com 2 consultas
A primeira mostra o estado do recurso. Se vier DISABLED, o caso é outro, alguém desligou. No cenário deste post ela veio ENABLED, e é justamente isso que confunde.
Ambiente de execução: banco em papel primário, primeiro nó, sessão SQL*Plus conectada como SYSDBA.
SET LINESIZE 200
SET PAGESIZE 100
SET HEADSEP '|'
COL DB_NAME    FORMAT A12 HEADING 'DB|NAME'
COL DB_ROLE    FORMAT A18 HEADING 'DATABASE|ROLE'
COL OPEN_MODE  FORMAT A20 HEADING 'OPEN|MODE'
COL BCT_STATUS FORMAT A10 HEADING 'BCT|STATUS'
COL BCT_FILE   FORMAT A70 HEADING 'CHANGE TRACKING|FILE'
COL BCT_MB     FORMAT 999G999D99 HEADING 'BCT SIZE|(MB)'

SELECT d.name            AS db_name,
       d.database_role   AS db_role,
       d.open_mode       AS open_mode,
       b.status          AS bct_status,
       b.filename        AS bct_file,
       b.bytes/1024/1024 AS bct_mb
  FROM v$database d, v$block_change_tracking b;
A segunda é a que fecha o diagnóstico. Ela compara, por ciclo, o volume lido com o tamanho dos datafiles e mostra se o rastreamento foi usado.
SET LINESIZE 220
SET PAGESIZE 200
SET HEADSEP '|'
COL COMPL_TIME FORMAT A20       HEADING 'COMPLETION|TIME'
COL INC_LEVEL  FORMAT 999       HEADING 'INC|LEVEL'
COL QTD_FILES  FORMAT 9999      HEADING 'QTD|FILES'
COL GB_LIDOS   FORMAT 999G999D9 HEADING 'READ|(GB)'
COL GB_TOTAL   FORMAT 999G999D9 HEADING 'DATAFILE|(GB)'
COL PCT_LIDO   FORMAT 999D9     HEADING 'PCT|READ'
COL USED_BCT   FORMAT A08       HEADING 'USED|BCT'

SELECT TO_CHAR(TRUNC(completion_time,'HH24'),'DD/MM/YYYY HH24:MI') AS compl_time,
       incremental_level AS inc_level,
       COUNT(*)          AS qtd_files,
       SUM(blocks_read     * block_size)/1024/1024/1024 AS gb_lidos,
       SUM(datafile_blocks * block_size)/1024/1024/1024 AS gb_total,
       ROUND(SUM(blocks_read)/NULLIF(SUM(datafile_blocks),0)*100,1) AS pct_lido,
       MAX(used_change_tracking) AS used_bct
  FROM v$backup_datafile
 WHERE incremental_level > 0
   AND completion_time > SYSDATE - 15
 GROUP BY TRUNC(completion_time,'HH24'), incremental_level
 ORDER BY 1 DESC;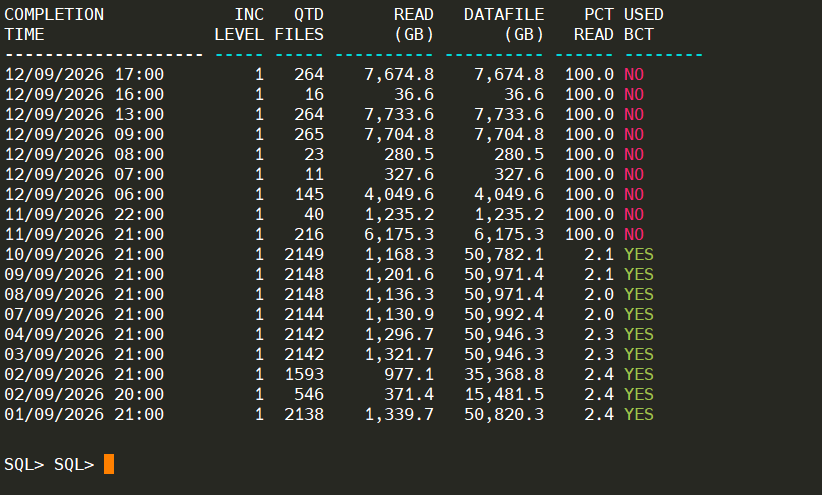
Quem quiser o detalhe por datafile, em vez do agregado, cruza V$BACKUP_DATAFILE com V$BACKUP_SET e olha USED_CHANGE_TRACKING e USED_OPTIMIZATION linha a linha.
Os números do caso
Ambiente sanitizado: banco PRODDB, RAC de dois nós, cerca de 51 TB de datafiles, backup para fita. Os valores abaixo saíram das visões do próprio banco.
Nos quatro ciclos anteriores à virada, o incremental leu de 1,13 a 1,20 TB por execução, de 2,0 a 2,1% dos datafiles, com USED BCT em YES. Depois da virada, 100% em toda execução. O volume lido ficou abaixo dos 51 TB porque a janela estourava antes de percorrer todos os datafiles.
Agora a parte que mata a discussão de que o full também lê tudo. Cruzando o volume efetivamente gravado com a duração de cada execução:
| Execução | Gravado | Duração | Backup por hora |
|---|---|---|---|
| Nível 0 concluído | 26.963 GB | 18h07 | cerca de 1.487 GB |
| Incremental com rastreamento | 519 a 613 GB | cerca de 1h20 | 427 a 449 GB |
| Incremental sem rastreamento | 99 a 328 GB | 1h32 a 2h29 | 47 a 174 GB |
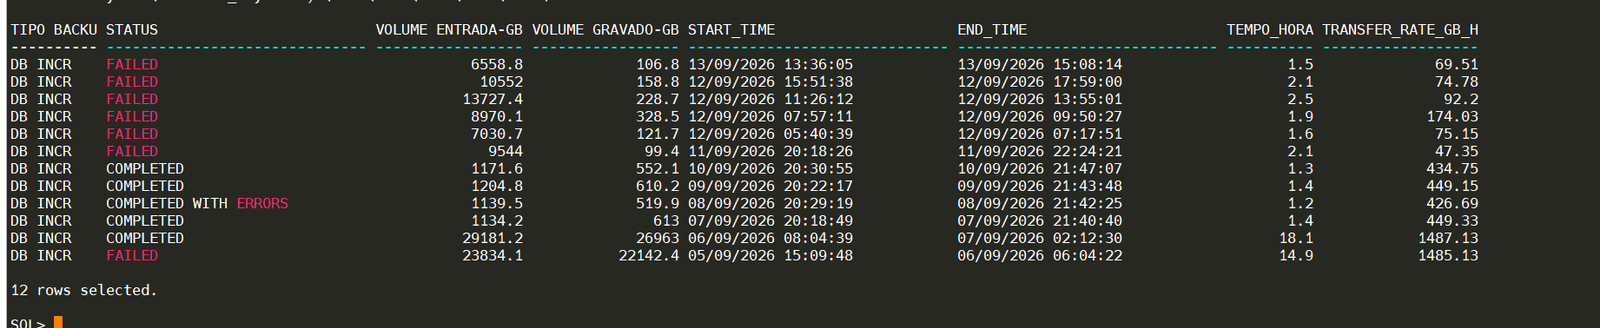
O nível 0 produz cerca de dez vezes mais backup por hora de janela do que o incremental sem rastreamento. Ler tudo uma vez, de forma planejada, sai muito mais barato do que ler tudo todo dia para gravar 100 GB.
Full, incremental com rastreio e incremental sem rastreio
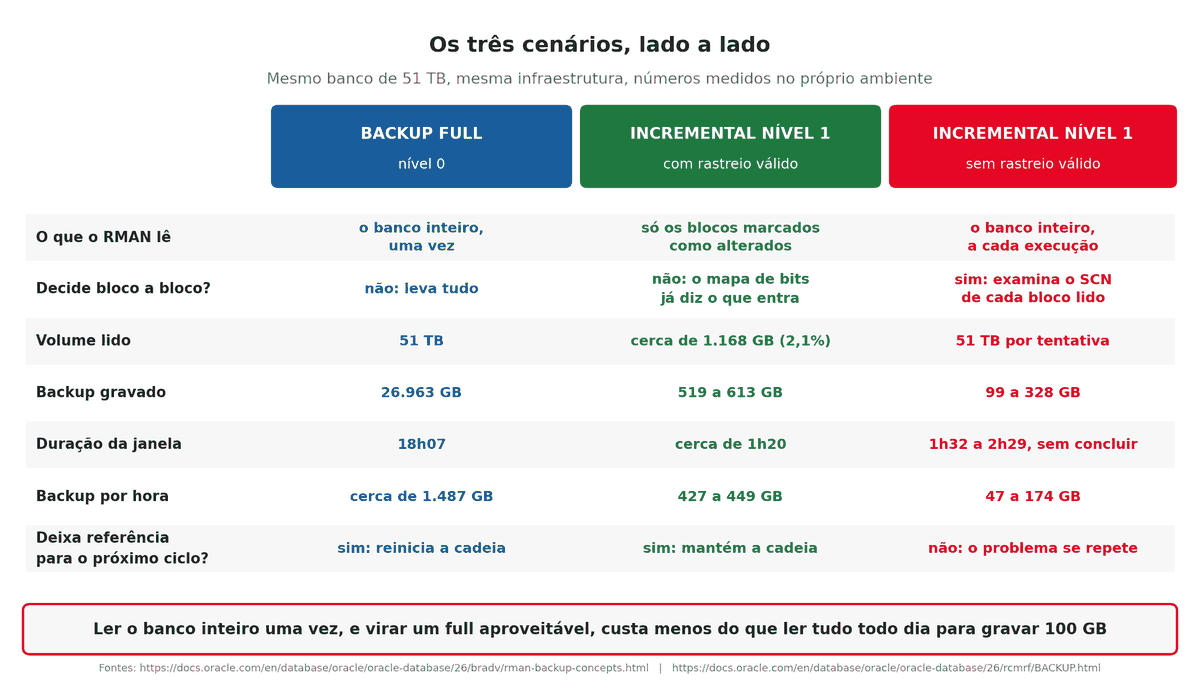
O nível 0 lê o banco inteiro uma vez, não compara nada e grava tudo em fluxo contínuo. Entrega um backup completo e uma referência nova para a cadeia.
O nível 1 com rastreio válido lê só os blocos que o mapa de bits aponta: janela curta e cadeia seguindo em frente.
O nível 1 sem rastreio válido junta o pior dos dois. Lê como um full, examina o SCN de cada bloco, grava uma fração mínima e não deixa referência. Na execução seguinte, tudo de novo.
A correção em 3 passos
Passo 1: executar um LEVEL 0 (full) na próxima janela. O arquivo de rastreamento continua o mesmo, não precisa mexer nele. Quem restabelece a referência é o nível 0: ele passa a ser o backup pai, e os bitmaps abertos a partir dali cobrem o período que o incremental seguinte precisa. Programe em horário de menor concorrência, porque a leitura vai ser integral. Essa é a única leitura integral que vale a pena.
Passo 2: validar o ciclo seguinte. Rode de novo a segunda consulta. O esperado é USED BCT igual a YES e PCT READ de volta ao patamar histórico do ambiente. No caso deste post, cerca de 2%.
Passo 3: recriar o arquivo, só se ele estiver com problema. Recriar não faz parte da correção normal. Isso só entra se o arquivo não existir no servidor, estiver inacessível ou o banco reclamar dele. Como recriar zera o histórico de bitmaps, o nível 0 tem que vir depois, não antes.
Os comandos abaixo são só para esse caso do passo 3, não para a correção do dia a dia. Ambiente de execução: banco em papel primário, primeiro nó, sessão SQL*Plus conectada como SYSDBA. Ajuste o diskgroup conforme o ambiente.
ALTER DATABASE DISABLE BLOCK CHANGE TRACKING;
ALTER DATABASE ENABLE BLOCK CHANGE TRACKING USING FILE '+DATA';Se o controlfile apontar para um arquivo de rastreamento que não existe no servidor, o banco reclama com ORA-19755. O disable antes do enable resolve esse caso também.
O que colocar no runbook de switchover
Toda troca de papéis, inclusive teste de contingência, entra com estes itens:
- Antes da virada, registrar o estado do rastreamento nos dois lados e a data do último backup concluído.
- Logo após a volta, conferir o estado do rastreamento no banco que assumiu o papel primário.
- Na primeira janela após a virada, executar o backup como LEVEL 0, com janela dimensionada para leitura integral.
- Na janela seguinte, validar o incremental pela coluna
USED_CHANGE_TRACKING.
O teste de contingência não acaba quando os papéis voltam ao lugar. Acaba quando o nível 0 concluiu e o incremental seguinte voltou ao patamar normal. Sem isso, a conta chega dias depois, com a janela estourando, e ninguém liga uma coisa à outra.
Observado em ambiente real, com dados sanitizados:
USED_CHANGE_TRACKINGigual a NO e percentual lido de 100 em todas as execuções posteriores à troca de papéis, com o recurso ENABLED.- Percentual lido de 2,0 a 2,4 nos ciclos anteriores à troca, com
USED_CHANGE_TRACKINGigual a YES. - Taxas de produção de backup por hora de janela conforme a tabela acima.
- Consumo de disco do host no teto durante as janelas de backup, com latência de I/O elevada na HBA, e retorno ao padrão normal fora delas.
Conclusão
Block Change Tracking habilitado não quer dizer que o RMAN vai usar. Depois de um switchover e switchback, a cadeia de mapas de bits quebra, e o incremental volta a ler o banco inteiro só para decidir bloco a bloco o que gravar.
Insistir no incremental não resolve. O caminho é um LEVEL 0 na próxima janela, validação no ciclo seguinte e a regra escrita no procedimento de troca de papéis. Ler a base inteira uma vez, na hora que você escolheu, sai bem mais barato do que ler toda noite sem querer.